 配资实盘平台
你有没有想过一件事:为什么公司里那些做数据分析报表的岗位,到现在都没有被AI彻底取代?
按理说,写SQL查数据库这种事,AI早就会了。GPT系列模型在各种编程测试里表现都很不错,问它一个数据问题,它能秒回一段能跑的代码。可现实是,绝大多数企业的商业智能(BI)工作,还是得靠人工一步步来。
这篇来自UIUC和微软研究院的论文,把这个矛盾摆到了台面上,并且给出了一个让人有点意外的答案:目前最顶尖的AI大模型,在真实的商业分析任务上,正确率还不到50%。这不是一个小问题,这几乎是"一半时间都在犯错"的水平。
那问题到底出在哪儿?我们一步步拆开看。
**商业智能到底难在哪**
先说说传统的BI工作流程是什么样的。想象你是一家连锁超市的分析师,老板让你回答一个问题:"按月份和年份对比销售额、预算和预测数据。"
听起来是个简单的查询,对吧?但实际操作起来,你得先在几十个数据表里翻找出跟这个问题相关的表格,比如销售表、预算表、日期表。这一步就叫做"搜索"。
找到表之后,你会发现麻烦才刚开始。很多原始数据是从Excel导出来的,格式乱得离谱。比如销售表可能是这样的:每一行是一个门店,每一列是一个月份,中间的数字是当月销售额。这种表格在Excel里看着很直观,但对数据库来说完全没法直接用。
**透视表**:一种把数据按行和列交叉排列的表格形式,常见于Excel导出的原始数据,但不方便直接做关联查询和汇总计算。
要把这种"月份当列名"的表格,转换成"月份是一列普通数据"的标准表格,这个操作在数据处理里叫"逆透视"。为什么非要做这一步?因为如果月份是列名,你想按月份把销售表和预算表关联起来,几乎是不可能的,除非你把销售表的几十个月份列一个个手动拆开、再用SQL的UNION语句硬拼起来,这个过程又慢又容易出错。论文里给了个真实例子:如果不转换,光是模拟一次逆透视操作,SQL代码可能要写几十行重复的UNION ALL语句。
这就好比你搬家的时候,家里东西是按"哪个房间"分类打包的,但搬到新家你需要按"厨房用品、卧室用品"重新归类才能找东西。如果不重新归类,直接把箱子一股脑堆在客厅,你以后找一个碗都要翻遍所有箱子。数据表如果不做这层转换,后面每一次关联查询都要额外承受这种"翻箱子"的成本。
表格转换好之后,还有第三个难题:怎么把不同的表关联起来。真实的商业项目里,表之间的关联关系可能有十几甚至上百条,还夹杂着大量看起来相似但实际含义不同的编号,比如门店编号、产品编号、促销编号。这些编号本身没有业务含义,纯粹是技术性的标识符,AI很容易把不该关联的两张表错误地拼在一起。
做完这三步,才能真正开始"分析"这一步,也就是写代码算出老板想要的结果。
传统BI软件比如微软的Power BI、Salesforce旗下的Tableau,就是靠这套流程运转的。这两款软件全球一共服务了超过10万家企业,但它的门槛一直很高,非技术背景的普通员工想独立完成这套流程,相当吃力。
**没有真实数据,怎么测试AI的真实水平**
论文作者们意识到一个问题:市面上已有的很多AI测试数据集,比如经常被拿来评估AI写SQL能力的BIRD和Spider,其实都跳过了"搜索、转换、关联"这三个前置步骤,直接给AI一份已经整理干净的表格,只考它最后的分析能力。
这就好比考驾照只考倒车入库,却不考你上路前怎么规划路线、怎么应对突发路况。这些测试能反映AI某一方面的能力,但完全没法反映AI能不能真的顶替一个分析师完成一套完整的工作。
为了填补这个空白,研究团队干了一件挺硬核的事:他们从网上爬取了3000多个真实的Power BI项目文件,这些文件是各行各业的用户自己上传、公开可访问的,涵盖了完整的原始数据、用户手动写的转换逻辑,以及最终做出来的仪表盘。
然后,他们从这些真实项目里,手工筛选出100个高质量的测试案例。每个案例都是一个真实用户曾经问过的业务问题,配上从对应仪表盘里导出的正确答案表格。这个筛选过程极其耗时,团队花了超过400人工小时,平均每道题要审4个多小时。
为什么要这么较真?因为很多可视化图表的标题本身就写得很模糊,比如某张图只写"销售趋势",你根本猜不出它具体过滤了哪些条件、统计了哪个时间段。研究者必须去反查图表背后的实际计算逻辑,确认这个问题的表述和实际结果是完全对得上的,才能收进测试集。
他们甚至还找了两个独立的顶尖AI模型,给它们提供各种"简化提示",比如直接告诉AI需要用哪几张表、怎么关联,让AI在近乎"开卷"的条件下尝试10次。如果两个模型都做不出正确答案,团队就会再进行一轮人工复核,看看是不是测试题本身有问题。这个过程里,有14.4%的案例确实是团队自己的提取流程出了错,被修正了;有5.2%的案例因为存在真正的语义模糊,被直接淘汰。但也有3.5%的案例,人工确认题目没问题,AI就是做不出来,这些题目被原样保留,不做任何修改来"讨好"AI。
这个细节挺打动我的。很多benchmark建设者可能会为了让AI"看起来做得不错"而悄悄剔除AI做不出来的难题,但这个团队反着来,专门保留AI搞不定的真实难题,就是为了让这个测试集诚实地反映现实的差距。
最终这个测试集起名叫BI-Bench,覆盖了销售、金融、教育、医疗、政府等多个行业领域,销售类占比最高,达到30%。
**AI到底差在哪,差多少**
有了这套真实的测试题,研究团队开始"考"各种AI模型。
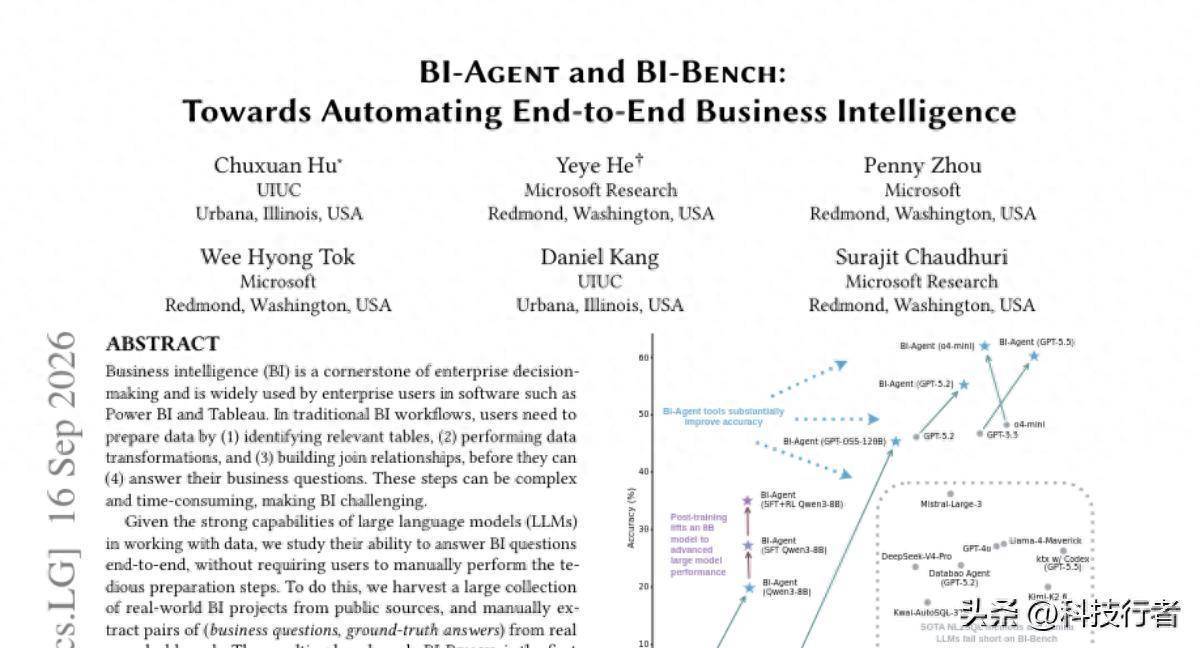
结果相当扎心:即便是当时最强的推理模型o4-mini,用SQL做题的正确率也只有48.2%,还经常需要反复交互很多轮才能勉强做出答案。而那些在BIRD、Spider这类传统NL2SQL排行榜上表现亮眼、正确率超过70%的专业模型,放到BI-Bench上直接跌到6%到26%不等。
**NL2SQL**:把自然语言问题自动转换成SQL查询语句的技术方向,是目前AI辅助数据分析研究的主流方向之一。
这个落差说明一个问题:擅长写SQL代码和擅长做完整的商业分析,根本是两种不同的能力。前者是"给你干净的食材,做一道菜",后者是"你先要去菜市场挑食材、洗菜、切菜,然后才能做菜"。市面上大部分AI评测,一直在考"做菜"这一步,而完全没考"买菜洗菜"这些前置功夫,而这恰恰是商业分析里最耗时、最容易出错的部分。
那AI具体在哪些环节栽了跟头?研究者对失败案例做了详细的错误分类,最常见的错误类型是"表选择错误"和"表格转换错误",也就是前面提到的那两个前置步骤。AI经常会漏掉必要的表,或者选进来一堆不相关的表;面对需要逆透视转换的原始表格,AI往往意识不到需要转换,或者意识到了却写不对转换代码。
为什么AI在这块特别吃力?论文给出了一个挺有意思的解释:判断该不该做数据关联,需要看两张表里的具体数值有没有重叠。但真实的商业数据表动辄几百万行,AI的提示词里只能塞进去几行样例数据,根本没法靠"扫一眼"就判断出可靠的关联关系。这就像让你只看一本书的目录和前三页,就去判断这本书是不是另一本书的续集,信息量根本不够。
**给AI配上专业工具,效果立竿见影**
既然AI自己单打独斗搞不定这些数据处理的脏活累活,研究团队想到一个思路:既然数据管理领域早就有专门针对这些问题设计的成熟算法,为什么不直接把这些算法包装成AI能调用的"工具",让AI学会在需要的时候去调用它们?
这就是这篇论文提出的第二个核心贡献:BI-Agent。
**智能体(Agent)**:一种能够自主决策、多轮调用外部工具来逐步解决复杂任务的AI系统,区别于只做单轮问答的普通对话模型。
BI-Agent给AI配备了四种工具。第一种是常规的代码执行工具,AI写的Python或SQL代码可以在这里真实运行,得到结果或报错信息,反馈给AI继续调整。第二种是专门的"转换工具",内置了成熟的表格重整算法,能自动判断一张表是不是需要做逆透视之类的转换,并且直接完成转换。第三种是"关联工具",用专门针对雪花状、星型结构的商业数据库设计的算法,去全局扫描所有表格,找出真正可靠的关联关系,而不是像AI那样只能盯着几行样例数据瞎猜。第四种是"搜索工具",帮AI从一堆表格里快速筛出跟当前问题真正相关的那一批。
这套设计的效果非常明显。给各种大模型配上这四个工具之后,正确率平均提升了14个百分点(用SQL时)和11个百分点(用Python时),而且几乎所有的提升在统计上都是显著的,不是运气好蒙对的。
其中最夸张的例子是开源模型GPT-OSS-120B。这个模型本身编程能力很强配资实盘平台,但没有工具辅助时,正确率只有5.3%,因为它面对复杂数据时几乎"懒得看数据
文章为作者独立观点,不代表配资助手网_配资平台下载_恒汇证券观点